Как устроен агент: архитектура поверх LLM
Про архитектуру трансформеров написано уже немало, поэтому опишу работу LLM с прикладной точки зрения.
Контекст
На вход LLM подаётся блок текста, который называется контекстом. Размер контекста ограничен: когда всё начиналось, прорывом считались 32К, сейчас 1М - индустриальный стандарт.
На основе этого текста LLM генерирует его продолжение. Современные модели выдают логически законченный фрагмент (на уровне модели он завершается специальным токеном <stop>).
Контекст таким образом увеличивается: к нему можно дописать новый фрагмент - и всё повторяется заново.
Вызов инструментов
Модель обучена использовать специальное форматирование для вызова внешних функций. В разных моделях оно отличается; ниже все примеры даны в формате Anthropic.
Чтобы модель знала, какие инструменты ей доступны, их нужно предварительно задекларировать, то есть добавить в начало контекста. Эта часть называется "системным промптом", но по сути ничем не отличается от остального контекста - за исключением того, что модель вставляет специальный токен-разделитель и обучена не афишировать содержимое до этого токена.
Для описания инструментов есть стандарт - JSON Schema. В сыром промпте это выглядит примерно так:
Here are the functions available in JSONSchema format:
<functions>
<function>
{
  "name": "get_delivery_status",
  "description": "Возвращает текущий статус доставки заказа по его идентификатору. Используй, когда пользователь спрашивает, где посылка, когда она придёт или что с ней происходит.",
  "input_schema": {
    "type": "object",
    "properties": {
      "order_id": {
        "type": "string",
        "description": "Идентификатор заказа, например "RU-9948"."
      },
      "detailed": {
        "type": "boolean",
        "description": "Если true - вернуть полную историю перемещений, а не только текущий статус. По умолчанию false.",
        "default": false
      }
    },
    "required": ["order_id"]
  }
}
</function>
</functions>
Фактически это документация инструмента на естественном языке, и она должна содержать всю информацию, необходимую для его вызова.
Имея описания в контексте, модель может генерировать вызовы. Выглядит это так:
<function_calls>
<invoke name="get_delivery_status">
<parameter name="order_id">RU-9948</parameter>
<parameter name="detailed">true</parameter>
</invoke>
</function_calls>
Harness и MCP
Набор инструментов, доступных модели, сейчас принято называть harness (упряжь).
Для описания и вызова инструментов, которые не зашиты в самого агента, есть индустриальный стандарт - MCP (Model Context Protocol). Фактически он описывает IPC (inter-process communication) между агентом и сторонними системами. Обмен в обоих случаях идёт по JSON-RPC 2.0, различается только транспорт: stdin/stdout локального процесса-сервера (олды ещё помнят FastCGI?) либо HTTP для внешних серверов.
Что возвращает API
Само API LLM-провайдера, как правило, возвращает не сырой текст, а типизированные JSON-объекты.
Единого официального стандарта (вроде ISO) для этого пока нет: у каждого крупного провайдера формат свой. Самый распространённый - OpenAI Tools API, его же воспроизводят опенсорсные движки вроде Ollama и vLLM. У Anthropic собственный формат, и дальше примеры даны в нём.
Ответ Messages API выглядит так:
{
  "id": "msg_01Aq9w8gH3Nn4kLpZ2vXyR7t",
  "type": "message",
  "role": "assistant",
  "model": "claude-sonnet-4-5",
  "content": [
    {
      "type": "text",
      "text": "Сейчас посмотрю, где ваша посылка."
    },
    {
      "type": "tool_use",
      "id": "toolu_01D7FLrfh4GYq7yT2xKm9WcB",
      "name": "get_delivery_status",
      "input": {
        "order_id": "RU-9948",
        "detailed": true
      }
    }
  ],
  "stop_reason": "tool_use"
}
Вызов инструмента приезжает отдельным блоком в массиве content: у него есть id, имя и input - уже разобранный объект, а не строка с JSON (в формате OpenAI аргументы приходят строкой, и её нужно парсить самому). Признак того, что ход не закончен, - поле stop_reason со значением tool_use.
Результат выполнения возвращается новым сообщением с ролью user и блоком tool_result, который ссылается на id вызова:
{
  "role": "user",
  "content": [
    {
      "type": "tool_result",
      "tool_use_id": "toolu_01D7FLrfh4GYq7yT2xKm9WcB",
      "content": "Заказ RU-9948: в пути, отделение Москва-Внуково, ожидаемая доставка 16 сентября."
    }
  ]
}
Ошибка как обратная связь
У блока tool_result есть флаг is_error. Ставится он, когда инструмент упал: команда вернула ненулевой код, файл не нашёлся, тест не прошёл.
{
  "role": "user",
  "content": [
    {
      "type": "tool_result",
      "tool_use_id": "toolu_01D7FLrfh4GYq7yT2xKm9WcB",
      "is_error": true,
      "content": "Traceback (most recent call last):\n  File "app.py", line 14, in <module>\n    math.sqrt(x)\nNameError: name 'math' is not defined"
    }
  ]
}
Ничего особенного с точки зрения цикла тут не происходит: ошибка - такой же результат вызова, как и успешный. Цикл не прерывается, агент делает следующий ход, просто теперь он знает, что импорт забыт, и на этот раз допишет строку.
Именно это и замыкает обратную связь со средой. До появления инструментов модель писала код вслепую: сгенерировала - и всё, дальше разбирайтесь сами. Теперь она видит последствия собственных действий и может их учесть. Одноходовая генерация превращается в многоходовую, а вместе с ней появляется то, чего у генератора текста не было в принципе, - способность себя исправлять.
Агентский цикл
Таким образом, получаем простой агентский цикл:
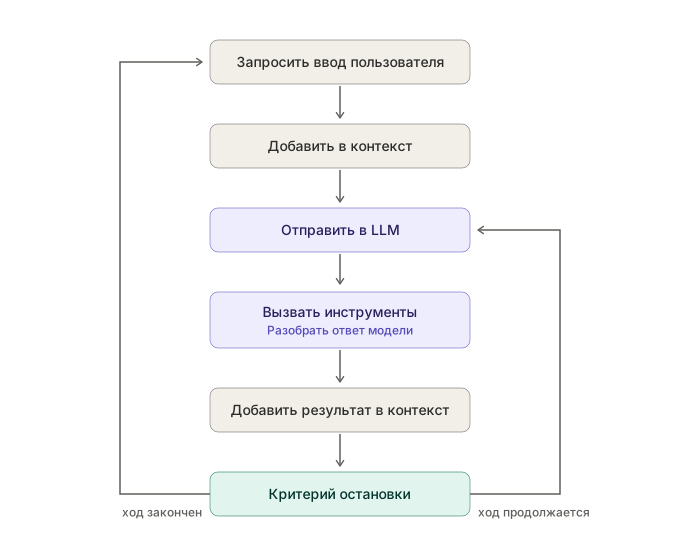
Как видим, всё очень просто. Современные модели умеют сами сообщать, что ход закончен, но на практике признак тот же: в ответе больше нет вызовов инструментов.
Управление контекстом
Размер контекста ограничен, и рано или поздно он кончается. Здесь важно различать два лимита. Формальный - тот, что указан в спецификации модели: при его превышении API просто вернёт ошибку. И рабочий - объём, на котором модель ещё держит качество. Второй заметно меньше первого: на длинном контексте начало и конец остаются в фокусе, а то, что оказалось посередине, начинает выпадать.
Для борьбы с этим используют несколько приёмов.
Вытеснение в файлы
Вызовы инструментов могут возвращать тысячи строк текста. Чтобы это не сжигало контекст, в него помещают только небольшую часть вывода (10-20 строк файла, хвост лога), а остальное записывают во временный файл и кладут рядом путь до него.
Модель при необходимости извлечёт из этого файла нужное отдельным вызовом инструмента.
Компактификация
Это подход, при котором весь контекст заменяется краткой выжимкой. Делается это так же при помощи LLM: специальный системный промпт конкатенируется с историей сессии, и полученная выжимка занимает место прежнего контекста.
Вот (русифицированный и урезанный) пример такого промпта:
Твоя задача - составить подробное резюме диалога, уделяя особое внимание явным запросам пользователя и твоим предыдущим действиям.
Это резюме должно тщательно фиксировать технические детали, паттерны кода и архитектурные решения, которые необходимы, чтобы продолжить работу над проектом, не потеряв контекст.

Резюме должно включать следующие разделы:

1. Основной запрос и намерение: подробно зафиксируй все явные запросы и намерения пользователя.
2. Ключевые концепции: перечисли все важные концепции, подходы и технологии, которые обсуждались.
3. ...и так далее
Итог
Как видим, LLM-агент устроен достаточно просто. Я сознательно опустил субагентов, файлы памяти и прочие механики, без которых базовая архитектура обходится.
Рекомендую каждому для практики написать агента на сыром API: можно уложиться в 200-300 строк кода и получить инструмент, немногим уступающий Claude Code или Codex. Сила агента по большей части определяется силой модели, а не набором доступных ей инструментов.